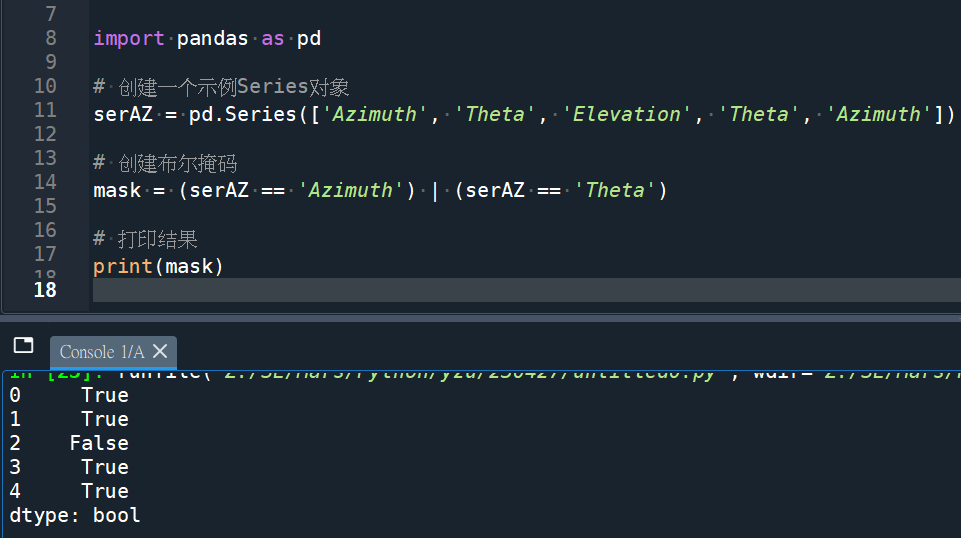
code:
import pandas as pd
# 创建一个示例Series对象
serAZ = pd.Series(['Azimuth', 'Theta', 'Elevation', 'Theta', 'Azimuth'])
# 创建布尔掩码
mask = (serAZ == 'Azimuth') | (serAZ == 'Theta')
# 打印结果
print(mask)輸出結果:

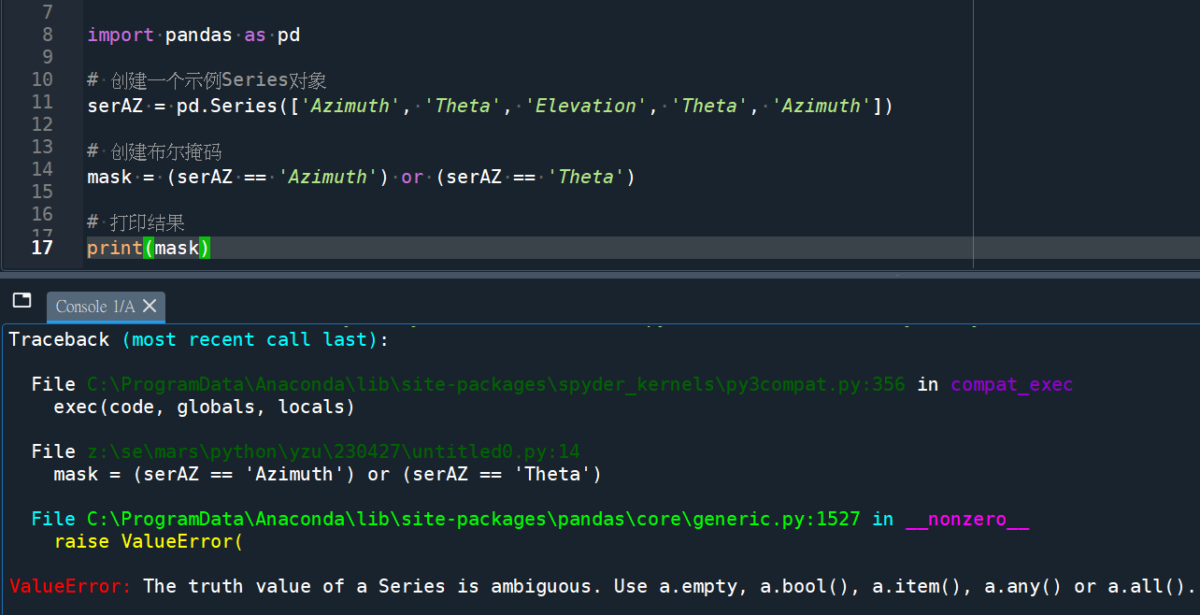
將|改為or,將觸發ValueError:

在 Python 中,用 or 時會先判斷左邊的表達式,
如果其為真則不會判斷右邊的表達式,
而直接返回左邊的結果。
而當左邊的表達式為 Pandas 的 Series 時,
該結果是一個包含多個布爾值的 Series。
這時就會引發 ValueError:
The truth value of a Series is ambiguous(模糊的) 的錯誤,
因為 Pandas 無法確定這個
包含多個布爾值的 Series 到底應該返回什麼值。
相反的,| 運算符會針對每個元素進行比較,
(類比 逐位元運算)
然後將結果組合成一個新的布爾值 Series。
因此,當您在 Pandas 中使用邏輯運算符時,
應該使用 | 而不是 or,
並使用括號將比較表達式括起來以避免優先級問題。
推薦hahow線上學習python: https://igrape.net/30afN


![Python: list.index() 只能找到第一個元素的index,若元素有重複,如何找出所有index? indexes = [index for index, value in enumerate(my_list) if value == target] Python: list.index() 只能找到第一個元素的index,若元素有重複,如何找出所有index? indexes = [index for index, value in enumerate(my_list) if value == target]](https://i0.wp.com/savingking.com.tw/wp-content/uploads/2024/10/20241010101216_0_12b6c0.png?quality=90&zoom=2&ssl=1&resize=350%2C233)


![Python PyMuPDF fitz 教學:從pdf中抓文字、抓 fonts、抓表格; pip install PyMuPDF ; import fitz ; text_dict = page.get_text(“dict”) #type(page) is pymupdf.Page ; blocks:list[dict] = text_dict[‘blocks’] ; page.find_tables().tables [0].extract() ;如何判斷粗體字? Python PyMuPDF fitz 教學:從pdf中抓文字、抓 fonts、抓表格; pip install PyMuPDF ; import fitz ; text_dict = page.get_text(“dict”) #type(page) is pymupdf.Page ; blocks:list[dict] = text_dict[‘blocks’] ; page.find_tables().tables [0].extract() ;如何判斷粗體字?](https://i1.wp.com/savingking.com.tw/wp-content/uploads/2026/05/20260527141829_0_5a8a75.png?quality=90&zoom=2&ssl=1&resize=350%2C233)


近期留言