新光人壽美添109建議書如下
若想了解IRR 5%的香港保單或其他台灣保單
複委託優惠或YTM超過6%的債券
請在此表單留下聯絡資料:
若您願意贊助我:
機構代號(391,一卡通),帳號:1501823311
FB粉絲團: 儲蓄保險王,
Line@: @wvr5039s,
Line社群: https://lihi1.com/MaSdv/blog
twitter: https://twitter.com/SavingKing925
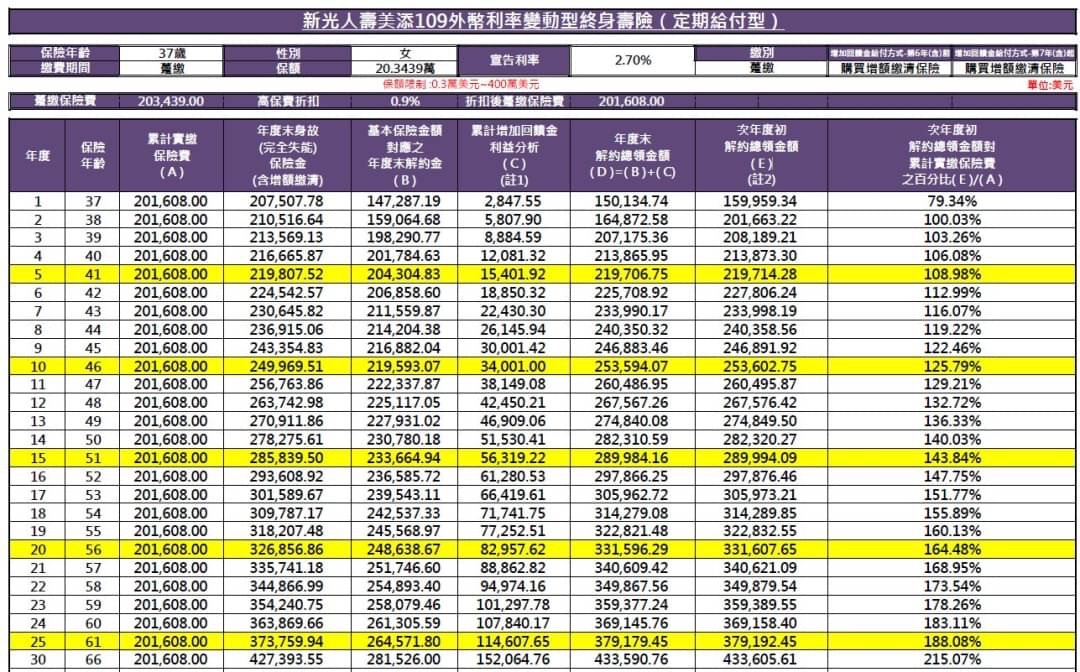
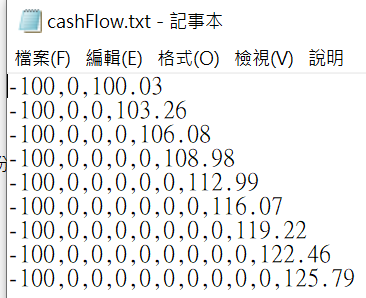
以下的cashFlow.txt
副檔名.csv亦可,
內容就是逗點分隔檔
每列現金流狀況與建議書一致
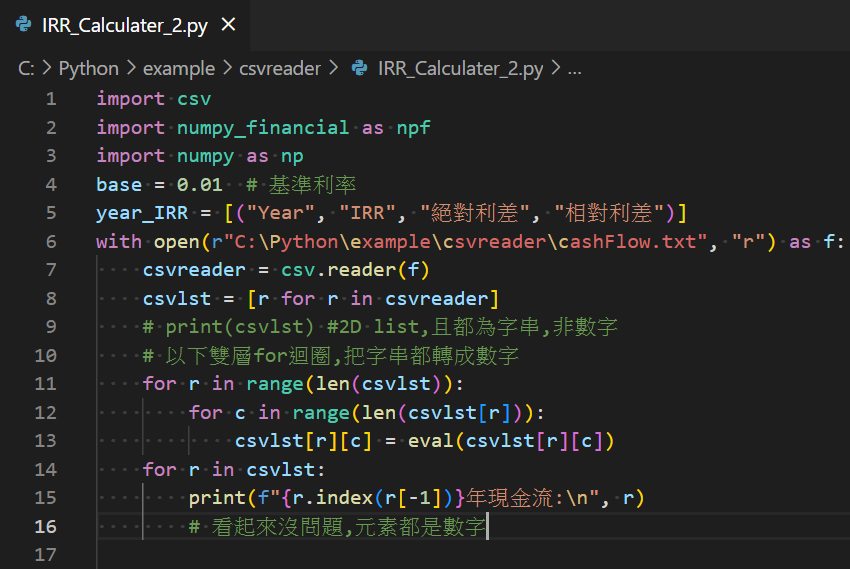
程式碼:
import csv
import numpy_financial as npf
import numpy as np
base = 0.01 # 基準利率1%,隨便key的,不用認真
year_IRR = [(“Year”, “IRR”, “絕對利差”, “相對利差”)]
with open(r”C:\Python\example\csvreader\cashFlow.txt”, “r”) as f:
csvreader = csv.reader(f)
csvlst = [r for r in csvreader]
# print(csvlst) #2D list,且都為字串,非數字
# 以下雙層for迴圈,把字串都轉成數字
for r in range(len(csvlst)):
for c in range(len(csvlst[r])):
csvlst[r][c] = eval(csvlst[r][c])
for r in csvlst:
print(f”{r.index(r[-1])}年現金流:\n”, r)
# 看起來沒問題,元素都是數字
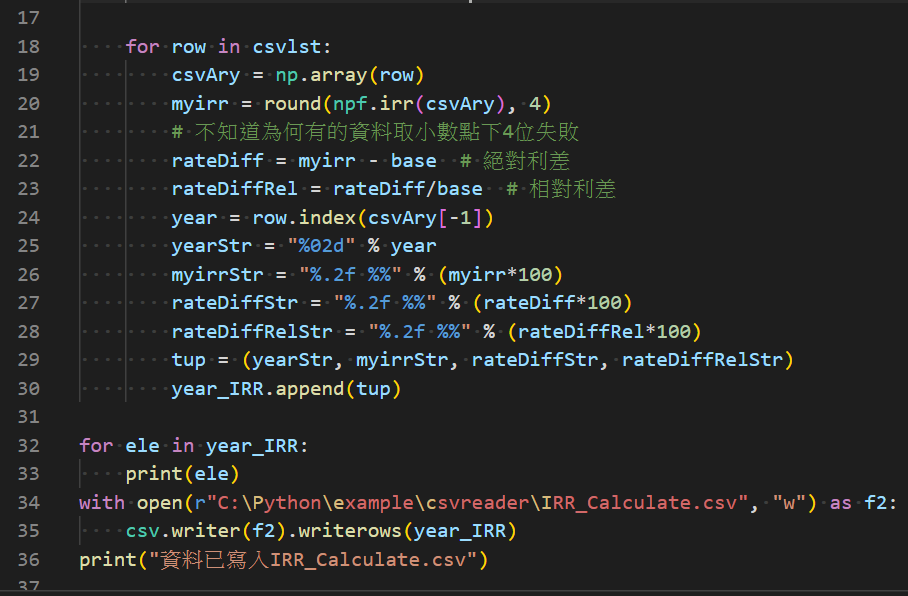
for row in csvlst:
csvAry = np.array(row)
myirr = round(npf.irr(csvAry), 4)
# round函數本身的問題,有的資料取小數點下4位失敗
rateDiff = myirr – base # 絕對利差
rateDiffRel = rateDiff/base # 相對利差
year = row.index(csvAry[-1])
yearStr = “%02d” % year
myirrStr = “%.2f %%” % (myirr*100)
rateDiffStr = “%.2f %%” % (rateDiff*100)
rateDiffRelStr = “%.2f %%” % (rateDiffRel*100)
tup = (yearStr, myirrStr, rateDiffStr, rateDiffRelStr)
year_IRR.append(tup)
for ele in year_IRR:
print(ele)
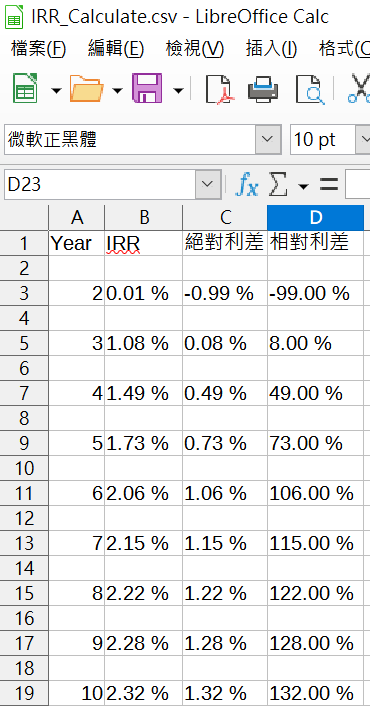
with open(r”C:\Python\example\csvreader\IRR_Calculate.csv”, “w”) as f2:
csv.writer(f2).writerows(year_IRR)
print(“資料已寫入IRR_Calculate.csv”)
輸出結果:
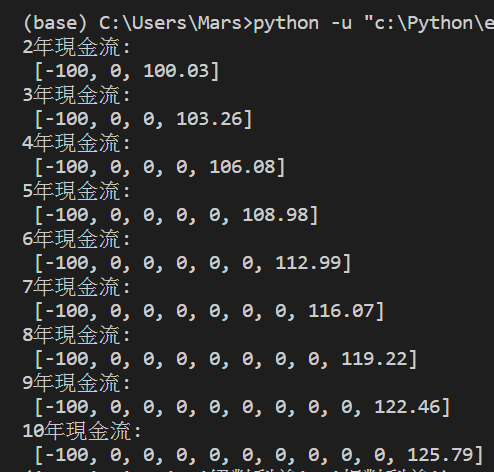
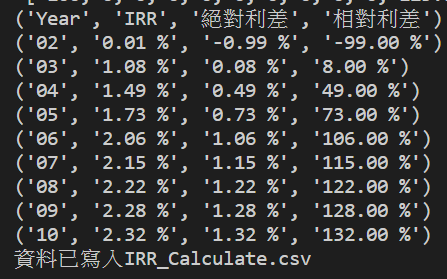
寫出的csv檔:


![Python: pandas.read_excel(r”路徑\檔名.副檔名”, header = None), 自動加上0,1…的欄標籤, DataFrame如何取某一直欄或橫列? 如何用 .iloc[bool_list] 取出判斷式為真的那一列? bool_list = list( df[0] == 0 ) ; bool_list = list(df[0].isin([0])) ; DataFrame如何顯示完整的資料? pandas.set_option ( “display.max_rows”, None) Python: pandas.read_excel(r”路徑\檔名.副檔名”, header = None), 自動加上0,1…的欄標籤, DataFrame如何取某一直欄或橫列? 如何用 .iloc[bool_list] 取出判斷式為真的那一列? bool_list = list( df[0] == 0 ) ; bool_list = list(df[0].isin([0])) ; DataFrame如何顯示完整的資料? pandas.set_option ( “display.max_rows”, None)](https://i1.wp.com/savingking.com.tw/wp-content/uploads/2022/11/20221128164005_44.png?quality=90&zoom=2&ssl=1&resize=350%2C233)


![Python: pandas.DataFrame 如何找出重複值並計算重複次數? counts = df[duplicates] .groupby([‘name’]) .size() .reset_index(name=’count’) Python: pandas.DataFrame 如何找出重複值並計算重複次數? counts = df[duplicates] .groupby([‘name’]) .size() .reset_index(name=’count’)](https://i2.wp.com/savingking.com.tw/wp-content/uploads/2023/03/20230316131103_65.png?quality=90&zoom=2&ssl=1&resize=350%2C233)


![Python 如何用pandas.Series.nsmallest() 找到n個與target差距最小的index?再從中找到距離idxmax最近的index?避免誤抓sidelobes的index? targetIdx = (serMean-target_value).abs().nsmallest(n).index.tolist() ;Series切片: .loc[標籤名1:標籤名2] (會含標籤名2) ; .iloc[位置1:位置2] (不含位置2) Python 如何用pandas.Series.nsmallest() 找到n個與target差距最小的index?再從中找到距離idxmax最近的index?避免誤抓sidelobes的index? targetIdx = (serMean-target_value).abs().nsmallest(n).index.tolist() ;Series切片: .loc[標籤名1:標籤名2] (會含標籤名2) ; .iloc[位置1:位置2] (不含位置2)](https://i0.wp.com/savingking.com.tw/wp-content/uploads/2023/02/20230222082954_53.png?quality=90&zoom=2&ssl=1&resize=350%2C233)

近期留言